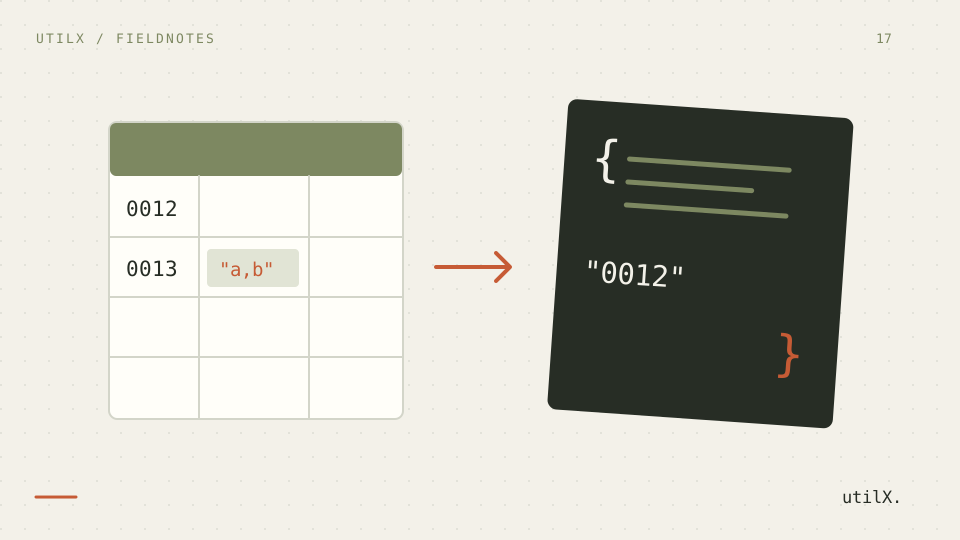
CSV nach JSON wirkt einfach, bis eine Kennung führende Nullen verliert, ein zitierter Zeilenumbruch einen neuen Datensatz bildet oder eine lange Ganzzahl gerundet wird. CSV-Felder sind Text, sofern eine konkrete Anwendung keine andere Bedeutung zuweist. Ein sorgfältiger Import trennt strukturelles Parsen von bewusster Typableitung.
Diese Anleitung verwendet das CSV-zu-JSON-Werkzeug mit zwei festen Zeilen. Geprüft werden ein Komma im Feld, mehrzeiliger Text, ein Leerfeld, führende Nullen, eine unsichere Ganzzahl, Wahrheitswerte und eine Dezimalzahl.
Struktur und Typen getrennt behandeln
CSV-Parsen bestimmt Feld- und Datensatzgrenzen sowie die Wirkung von Anführungszeichen. Typableitung entscheidet anschließend, ob Text zu Zahl oder Wahrheitswert wird. Werden beide Schritte unsichtbar vermischt, lässt sich ein Fehler kaum zuordnen.
Standardmäßig bleiben alle Werte Zeichenketten. 0012, true und ein leeres Feld werden "0012", "true" und "". Die optionale Ableitung wandelt exakte Wahrheitswerte und sichere Zahlen um, lässt aber führende Nullen, Datumsangaben und unsichere Ganzzahlen als Text. Datumswerte werden niemals geraten. Das ist ein vorsichtiger Vertrag und schützt fachliche Kennungen.
Eine Datei mit typischen Stolperstellen
Speichere exakt diesen UTF-8-Inhalt:
id,name,note,amount,enabled
0012,"Doe, Ana","Line one
Line two",9007199254740993,true
0013,Bela,,12.5,false
Mit Komma und ohne Ableitung sind sämtliche Eigenschaften Zeichenketten. Die erste Notiz enthält einen echten Zeilenumbruch, bleibt wegen der offenen CSV-Anführungszeichen aber ein Feld. Die zweite ist "". Beide Beträge und beide Wahrheitswerte bleiben Text.
Mit Ableitung bleibt id wegen der führenden Nullen Text. 9007199254740993 bleibt ebenfalls Text, weil JavaScript die Zahl nicht sicher darstellen kann. 12.5 wird Zahl, true und false werden Wahrheitswerte. Das leere Notizfeld bleibt eine leere Zeichenkette; Datumsähnliches würde Text bleiben.
In einer überprüfbaren Reihenfolge importieren
Wähle Komma und füge die Datei ein. Ein UTF-8-BOM am Anfang wird entfernt und nicht Teil der ersten Kopfzeile. Konvertiere zunächst ohne Typableitung. Erwarte genau zwei Objekte mit fünf Eigenschaften. Lade JSON herunter und parse es zusätzlich mit dem Werkzeug des späteren Prozesses.
Aktiviere anschließend die Ableitung. Nur enabled und der zweite Betrag dürfen ihren Typ ändern. Beide Kennungen und der große Betrag müssen zitiert bleiben. Der direkte Vergleich zeigt, ob der Empfänger interpretierte Werte oder ursprünglichen Feldtext benötigt.
Die Vorschau zeigt höchstens 100 Zeilen; der Download enthält alle bis 10.000. Prüfe deshalb die Array-Länge der Datei. Für einen späteren Tabellenexport nutze die JSON-zu-CSV-Anleitung und dokumentiere nicht umkehrbare Schritte.
Anführungszeichen, Zeilen und Kopfzeilen
RFC 4180 beschreibt die verbreitete Konvention: Datensätze enthalten Felder, Felder dürfen zitiert sein, innere Anführungszeichen werden verdoppelt und zitierte Felder dürfen Zeilenumbrüche enthalten. Reale Dateien unterscheiden sich, daher muss das gewählte Trennzeichen passen. Ein tabulatorgetrennter Datensatz mit Kommaeinstellung kann als einzige riesige Kopfzeile erscheinen.
Der erste Datensatz liefert Eigenschaftsnamen. Sie müssen eindeutig und nicht leer sein. Doppelte Namen können nicht eindeutig auf ein Objekt abgebildet werden; ein Leername erzeugt eine undokumentierte Eigenschaft. Beides wird in Zeile eins abgelehnt. Spätere Zeilen brauchen exakt gleich viele Felder, sonst nennt der Fehler die betroffene Zeile und verhindert verschobene Daten.
RFC 8259 erlaubt JSON-Zahlen, verbreitete Software arbeitet jedoch mit IEEE-754-Binär64. Number.isSafeInteger kennzeichnet exakt darstellbare Ganzzahlen. Die Zeichenkette 9007199254740993 bewahrt alle Ziffern, damit ein Folgeschema bewusst BigInt, Dezimaltyp oder Datenbankzahl wählen kann.
Fehler korrigieren, nicht verdecken
Doppelte oder leere Kopfzeilen sind im Quellschema zu beheben. Vergib stabile, fachliche Namen statt zufälliger Suffixe. Ein Fehler bei der Spaltenanzahl entsteht häufig durch ein unzitiertes Trennzeichen, ein fehlendes Schlusszeichen oder einen Zeilenumbruch im Feld. Prüfe auch die vorherige physische Zeile, weil ein offenes Zitat die Fehlerposition verschieben kann.
Die Fehlernummer zählt logische CSV-Datensätze ab eins, einschließlich der Kopfzeile. Sie bezeichnet keine physische Textzeile, denn ein zitierter Wert kann mehrere Textzeilen umfassen.
Bei ungültigem CSV korrigiere die Zitierung, statt Satzzeichen zu löschen. Ein Anführungszeichen im zitierten Feld wird doppelt geschrieben; ein Feld mit Komma oder Zeilenumbruch wird vollständig zitiert. Bei Semikolon oder Tabulator ändere zuerst die Einstellung.
Eingaben über 2 MiB, mehr als 10.000 Datenzeilen oder eine geschätzte JSON-Ausgabe über 16 MiB werden abgelehnt. Es entsteht kein plausibel aussehendes Teilarray. Teile nur zwischen vollständigen Datensätzen, wiederhole die Kopfzeile und gleiche Summen ab.
Kennungen und fachliche Bedeutung bewahren
Bestimme Typen nach Datenvertrag, nicht nach Aussehen. Postleitzahlen, Konten, Rechnungen und telefonähnliche Werte können ausschließlich Ziffern enthalten und dennoch Kennungen sein. Führende Nullen sind ein Hinweis, aber nicht die ganze Definition. Selbst 1234 kann Text bleiben müssen. Ohne eindeutiges Schema sollte die Ableitung ausgeschaltet bleiben.
Ein leeres Feld ist nicht automatisch null. Der Konverter erzeugt "", weil CSV nur Leere zeigt, nicht ihren Grund. Ein Quellsentinel wie NULL erfordert einen dokumentierten Folgeschritt. Auch 2026-09-17 bleibt Text, denn Zeitzone und Datumstyp fehlen.
Die Konvertierung läuft lokal, doch der JSON-Download ist eine neue Datenkopie. Prüfe Speicherort, Zugriff und Löschung. Verwende synthetische Beispiele. Bei strukturellen JSON-Problemen hilft die JSON-Fehleranleitung.
Grenzen automatischer Ableitung
Der Importer versteht Trennzeichen und CSV-Zitierung, entdeckt aber kein Schema, Einheiten, regionale Dezimalzahlen, Datumsformate, Nullregeln oder Dateibeziehungen. Die optionale Ableitung ist absichtlich eng. Sie wandelt weder Daten noch unsichere Ganzzahlen oder Zeichenketten mit führenden Nullen um.
Ein gültiges JSON-Array kann fachlich falsch sein. Pflichtfelder, Wertebereiche, feldübergreifende Regeln und Eindeutigkeit werden nicht geprüft. Die Vorschau endet bei 100, der Download bei 10.000 Zeilen; Eingabegrenze sind 2 MiB, geschätzte Ausgabegrenze 16 MiB. Für Produktionsimporte sind Schema-Validator oder Staging-Tabelle sinnvoll.
Abschließende Importprüfung
Bestätige UTF-8, Trennzeichen, Kopfzeilen und genaue Quellzeilenzahl. Prüfe eindeutige Namen und gleiche Feldanzahl. Konvertiere zuerst ohne Ableitung; untersuche führende Nullen, Leerfelder, Kommas, Zitate und mehrzeiligen Text. Schalte Ableitung nur für gewünschte sichere Zahlen und Wahrheitswerte ein.
Das Beispiel muss zwei Objekte liefern. 0012, 0013 und 9007199254740993 bleiben Text; der Zeilenumbruch und "" bleiben erhalten; nur 12.5, true und false werden bei Ableitung typisiert. Parse den vollständigen Download, vergleiche Längen und validiere anschließend das Zielschema. Teste zusätzlich doppelte Kopfzeile und eine Zeile mit Zusatzfeld, damit sichtbares Scheitern belegt ist.
Ergänze einen Test mit einem wörtlichen Anführungszeichen im Namen und verdopple es gemäß CSV-Regel. Prüfe nach dem Download, dass JSON nur das einzelne beabsichtigte Zeichen enthält. Teste außerdem Akzente in einer Datei mit und ohne BOM. Das BOM darf nicht Bestandteil des ersten Eigenschaftsnamens werden, und beide Varianten müssen bei korrekter UTF-8-Eingabe denselben Text liefern.
Wenn die Datei in Batches geteilt wird, notiere für jeden Teil Quellzeilenbereich, Datensatzanzahl und eine Integritätsangabe. Wiederhole identische Kopfzeilen und verbinde JSON-Arrays erst nach erfolgreicher Einzelprüfung. Ein Fehler in einem Teil darf nicht dazu führen, dass die übrigen Teile als vollständiger Import gelten. Der Zielprozess sollte Summen vor und nach der Zusammenführung vergleichen.
Typableitung ist keine Datenbereinigung. Werte wie TRUE, yes, 1,25 oder ein Währungssymbol werden nicht still normalisiert. Definiere solche Regeln außerhalb des strukturellen Imports, protokolliere Änderungen und teste den ursprünglichen Text. Dass ein Wert Zeichenkette bleibt, erlaubt dem fachlichen Validator eine bewusste Entscheidung.
Bewahre das ursprüngliche CSV unverändert und speichere die gewählten Optionen neben dem geprüften JSON. Bei einer späteren Abweichung lässt sich feststellen, ob Quelle, Parser, Ableitung oder Zielimport den Wert veränderte. Lösche Testkopien nach der vereinbarten Frist und verwende für Regressionstests das synthetische Fixture.
Prüfe zum Abschluss auch die Reihenfolge der Eigenschaften. Sie folgt der Kopfzeile und sollte nicht von einem nachgelagerten Formatierer als semantische Zusage verstanden werden. Verbraucher müssen über Namen zugreifen, nicht über die visuelle Position im JSON-Text. Halte die vereinbarte Kopfzeile dennoch stabil, damit Diffs und manuelle Kontrollen verständlich bleiben.
Dokumentiere außerdem die endgültige Reihenfolge der Kopfzeile.
Quellen: RFC 4180: CSV, RFC 8259: JSON und ECMAScript Number.isSafeInteger.